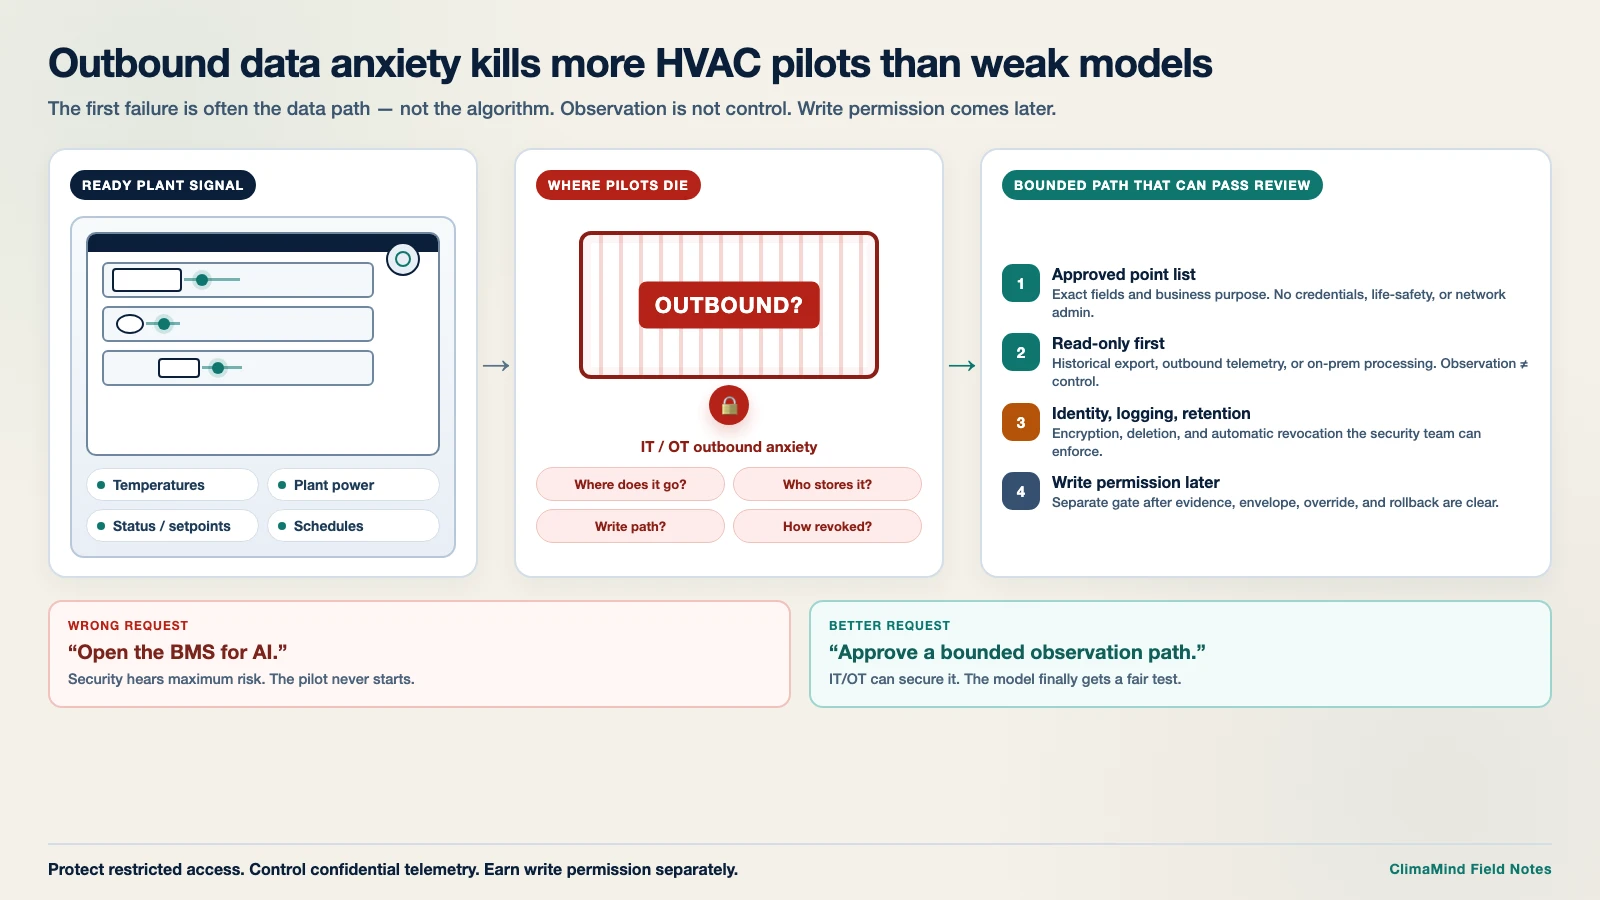
许多 HVAC 优化试点并不是因为模型弱才失败。
它们失败得更早:现场无法批准一条让运行数据离开本地控制环境的路径。
设施团队可能已经看到静态设定值、糟糕的启停,或松散的机房协同。能源侧有理由行动。算法在纸面上甚至看起来已经准备好了。
然后试点碰上了出站数据顾虑。
真正的障碍往往是数据路径
在真实建筑里,困难的对话很少是「强化学习是不是比规则曲线更好?」
它更接近:
- 这些数据去哪里?
- 谁可以存储?
- 保留多久?
- 走哪条网络路径?
- 这会不会形成进入 BMS 的写路径?
- 如果厂商连接失败或被撤销,会发生什么?
这些问题是合理的。楼宇自控是运营技术。一条草率的出站数据流,会带来真实的安全和运行风险。
可是,如果每一次数据请求都被当成通向机房的敞开门,项目就永远走不到足以证明节能、操作员工作流或控制质量的那一步。
结果很熟悉:有兴趣、一次安全审查、拖延,然后悄悄退回只做分析的工具。
模型质量不是第一个决策
模型质量是后面的事。现场首先要决定:一条有边界的观察路径是否可以存在。
没有获批的遥测,就没有可持久的基线。没有基线,就没有可信的计量路径。没有计量,就没有诚实的试点。没有试点,组织永远拿不到足以支撑后续写权限的证据。
这就是为什么出站数据顾虑能比弱模型杀死更多项目。模型从未得到一次公平的运行测试。
机房可以有杂乱趋势、不完整点位和不完美传感器,而仍然值得先做一次审查。它做不到的是:在每一条有用运行记录都被「不得离开本地网络」的一刀切禁令锁住时,还支撑闭环优化。
把离开建筑和控制建筑分开
出站数据访问和控制权限是两个不同的决策。
第一阶段试点可能只需要一份获批点表:温度、流量、状态、设定值、时间表,以及可用时的机房电量。它可以先从有时限的历史导出,或一条持续只读馈送开始。它不需要 BMS 管理权限。它不需要写权限。它不需要 BMS 暴露在公网。
回写是更晚的闸门。它需要自己的边界:哪些设定值可以改、哪些限制保持固定、操作员如何接管或回退,以及动作如何对照实测结果记录。
当这些阶段被压成一个请求——「把 AI 接到我们的 BMS」——安全团队听到的是最大可能风险,能源团队则失去了最小可用的第一步。
给 IT 和 OT 一个可以落实安全的请求
错误的请求是:为 AI 打开 BMS。
更好的请求是一条写清楚的数据路径:
- 精确点位和业务目的。
- 先只读,写权限除非另行批准否则排除。
- 优先处理方式:历史导出、出站只读遥测,或按要求在本地处理。
- 身份、加密、日志、保留、删除和撤销。
- 初始范围不含凭证、生命安全系统、门禁记录或网络管理。
- 明确声明:观察不等于控制。
这不是绕过安全。这是安全能够做出精确决定的唯一方式。
有些现场仍然要求处理留在本地。那是设计输入,不是自动的项目否决。架构应当适配现场的剩余风险姿态,而不是假装每栋建筑第一天都能接受同一条云路径。
顾虑是被边界降低的,不是被更大承诺降低的
出站顾虑不会因为厂商承诺更高节能而消失。
它会在现场能看见一条窄路径时下降:
- 只使用获批数据;
- 写明保留期限;
- 访问可撤销;
- 操作员可见;
- 后续写权限是单独挣来的决策;
- 计量能够说明改了什么、没改什么。
在 ClimaMind,我们把这条路径当成产品的一部分,而不是采购麻烦。监督式优化只有在建筑能够分享评估所需的运行证据之后才有用,也只有在控制仍然受现有 BMS 和机房责任人约束之后才可信。
如果试点在任何模型被测试之前就死了,不要先问算法够不够好。
先问:组织有没有定义过一条 IT、OT 和设施运行都能接受的数据路径。